
刘工判断:2026 年选大模型,看单一榜单已经没用了。MMLU 被顶到 88%-94% 之后彻底饱和,头部模型之间的差距要放到 GPQA(科学推理)、SWE-bench(真实编程)、AIME(竞赛数学)、ARC-AGI 2(抽象推理)和 Arena Elo(人类偏好)上去看。更现实的问题是:同样跑一个任务,成本可以差 90 倍。本文不罗列实验室口径,只做三件事——给一份 2026 年 10 月的数据快照,按场景拆出选型对照表,再以刘工作在视觉检测行业的落地经验,给出三条真正用得上的建议。
先说清楚:这份数据是什么
本文全部数字来自公开权威评测:LM Market Cap AI Benchmarks(2026 年 10 月 11 日更新)、SWE-bench Verified 与 LMArena 官方榜单、TokenPAPA 的 LLM API 实测(2026 年 9 月)以及 iternal.ai 的选型指南(2026 年 9 月,数据截至 7 月)。不同榜单口径略有差异,表格里已尽量统一到同一来源,但分值本身仅供参考——榜单差 2-3% 的模型在实际任务里几乎分不出高下。刘工不编造任何”实测跑分”,所有判断基于公开数字与从业观察。
2026 年 10 月头部模型快照
| 模型 | 厂商 | MMLU | GPQA Diamond | SWE-bench Verified | AIME 2025 | API 价格(输入/输出,$/1M) |
|---|---|---|---|---|---|---|
| GPT-5.4 | OpenAI | 94.0% | 92.0% | 约 80% | 88% | 2.50 / 15 |
| Claude Opus 4.6 | Anthropic | 92.1% | 91.3% | 80.8% | 99.8% | 5 / 25 |
| Claude Fable 5 | Anthropic | — | 92.6% | 95.0% | — | 10 / 50 |
| Gemini 3.1 Pro | 92.6% | 94.3% | 80.6% | 100% | 2 / 12 | |
| Grok 4 | xAI | 91.5% | — | — | 100% | — |
| DeepSeek R1-0528 | DeepSeek | 91.5% | 71.5% | 约 72% | 约 95% | 极低 |
| DeepSeek V4 Pro | DeepSeek | 89.4% | 67.1% | — | — | 0.18 / 0.65 |
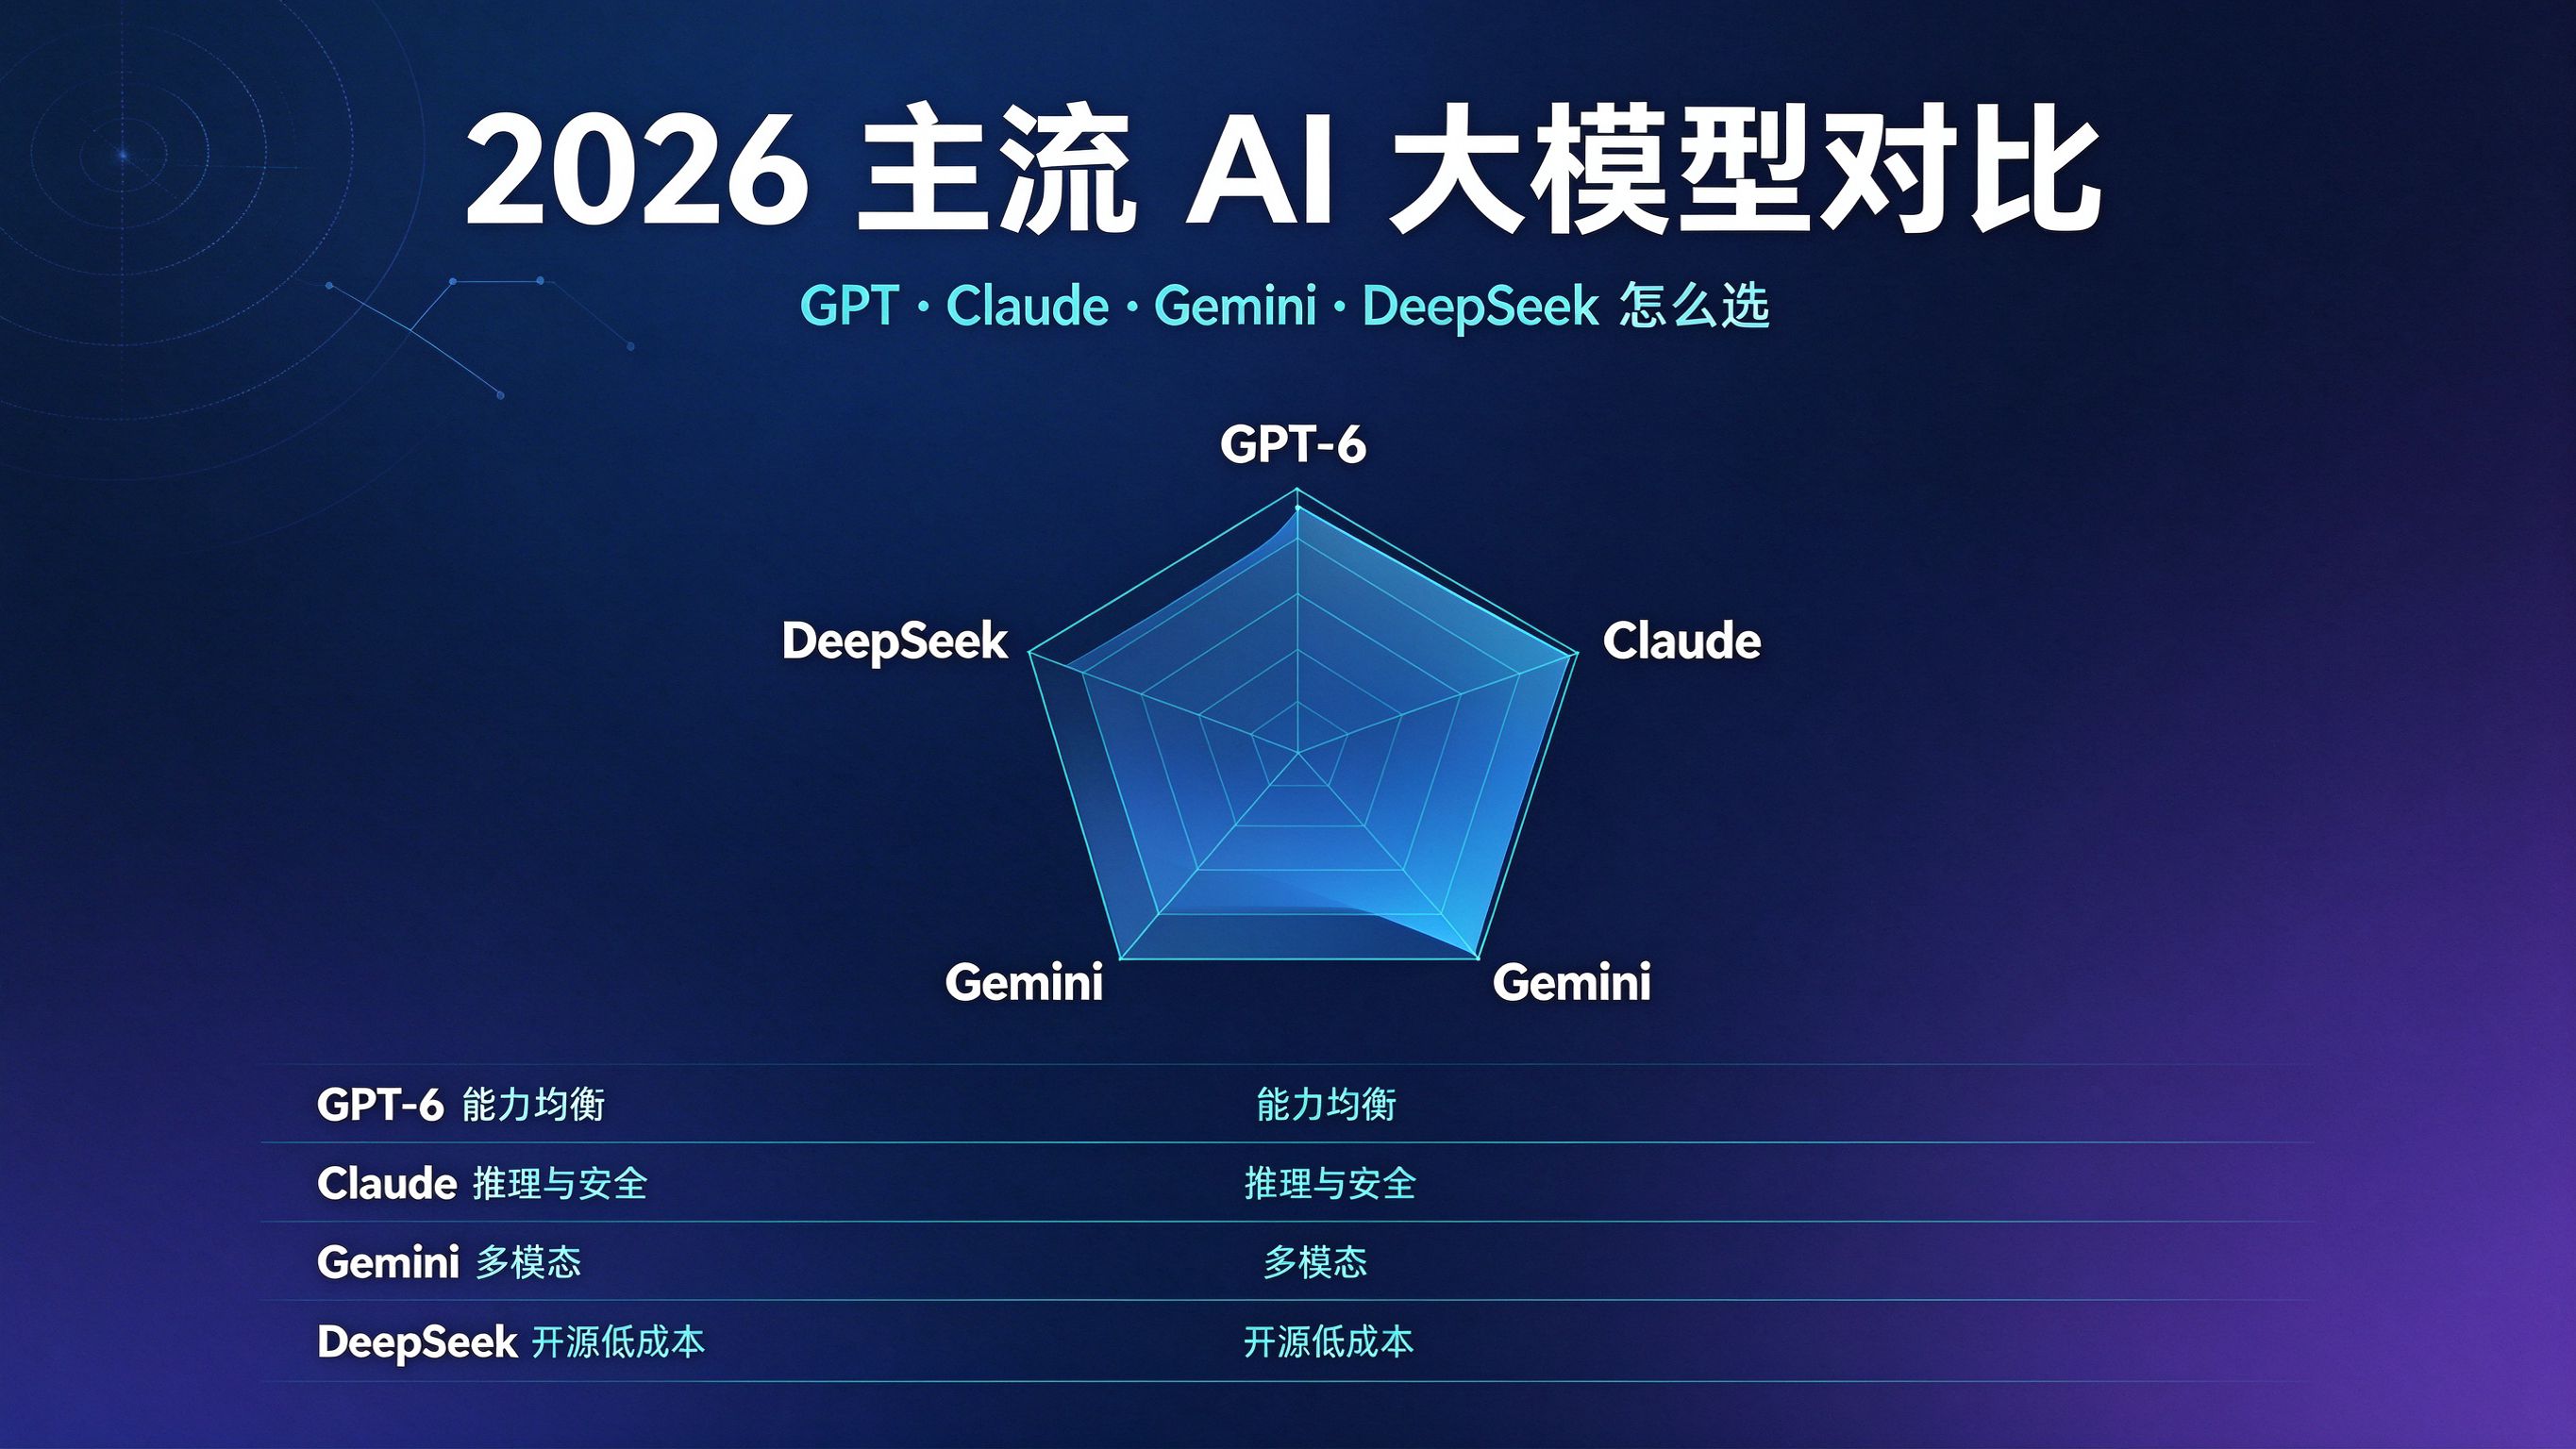
几点读法:MMLU 前三名都是 OpenAI 系,但 92% 以上的模型在实际问答里已经难以感知差异;真正能拉开差距的是 GPQA 与 SWE-bench。Claude Fable 5 在 SWE-bench 拿到 95.0%,是当前编程 Agent 的绝对天花板;Gemini 3.1 Pro 在 GPQA 94.3%、ARC-AGI-2 77.1% 双第一,多模态与科学推理没有对手。
闭源四强,逐个说优缺点
GPT-5.4(OpenAI):综合最均衡,计算机使用能力 OSWorld 75% 已超过人类专家基线,结构化推理与工具调用成熟,生态最全。短板是纯代码生成不如 Claude,数学(AIME 88%)在头部里靠后。定价 $2.5/$15 处于中位,是”不知道选什么就先选它”的稳妥项。
Claude Opus 4.6 / Fable 5(Anthropic):编程双雄。Opus 4.6 的 SWE-bench 80.8%、Arena 代码 Elo 1548,Fable 5 直接 95.0%。长文档、Agent 工作流、代码评审是它们的主场。短板:贵——Fable 5 每百万 token 输出要 $50,复杂任务跑一天就是一笔不小开销。
Gemini 3.1 Pro(Google):科学推理与多模态双料第一,GPQA 94.3%、AIME 100%、ARC-AGI-2 77.1%。图像/视频/文档理解全线最强,适合把”看懂东西”作为核心的团队。价格 $2/$12 甚至比 GPT-5.4 便宜,性价比突出。短板:生态接口相对分散,部分开发者的集成成本略高。
Grok 4(xAI):HLE(最难专家题)50.7% 领先,数学与极限推理强。但 API 生态、工具链成熟度与前三家有差距,多数场景还轮不到它。
中国军团:把价格打下来的性价比革命
2026 年最不该被忽略的变化在开源与国产侧。DeepSeek V4 Pro 用 $0.18/$0.65 的定价拿到 89.4% 的 MMLU——TokenPAPA 的实测里,1 万次复杂推理任务 DeepSeek V4 Pro 成本 $6.23,Claude 4 Sonnet 是 $90,差了 14 倍;简单分类任务 DeepSeek V4 Flash 只要 $0.71,GPT-5.4 Mini 是 $2.80。延迟方面 V4 Flash 首 token 约 150ms、每秒 180 tokens,实时场景完全够用。
开源侧同样凶猛:MiniMax M2.5 的 SWE-bench 80.2%,与闭源旗舰打平;GLM-5 77.8%、Kimi K2.5 76.8%。对需要私有化部署、数据不出内网的团队,这些开源权重已经是闭源模型的合格替代。
按场景选型:刘工给的对照表
| 场景 | 首选 | 次选 / 性价比 | 理由 |
|---|---|---|---|
| 编程 Agent / 代码评审 | Claude Fable 5 / Opus 4.6 | Gemini 3.1 Pro、GPT-5.4 | SWE-bench 95% 是当前天花板,差 2-3% 内选便宜的 |
| 科学推理 / 长逻辑 | Gemini 3.1 Pro | o3、Gemini Deep Think | GPQA 94.3%、AIME 100% 双第一 |
| 图像 / 视频 / 文档多模态 | Gemini 3.1 Pro | Gemini 3 Flash(MMMU Pro 81.2%) | 多模态理解目前无争议第一 |
| 高吞吐 / 成本敏感 | DeepSeek V4 Flash | Gemini 3 Flash($0.5/$3) | 1 万次任务成本只有旗舰的 1/10 到 1/60 |
| 私有化部署 / 数据不出网 | MiniMax M2.5 / GLM-5 / Kimi K2.5 | Qwen 3 系列 | 开源权重,SWE-bench 已接近闭源旗舰 |
成本:1 万次任务的真实账单
- – 简单分类:DeepSeek V4 Flash $0.71;GPT-5.4 Mini $2.80;Claude 4 Haiku $4 档——Flash 系成本优势 4 倍以上
- – 中等代码生成:DeepSeek V4 Pro $4.15;GPT-5.5 Max $62.50——差 15 倍
- – 复杂推理:DeepSeek V4 Pro $6.23;Claude 4 Sonnet $90.00——差 14 倍
- – 多提供商路由(简单任务走 Flash、复杂任务走旗舰、兜底走 Mini)比单一供应商省 66%(对比 GPT-5.4 Mini 单家)到 94%(对比 Claude 4 Sonnet 单家)
刘工的三条实战建议
第一,用任务跑分,不用榜单选型。刘工在工业质检项目里验证过:榜单差 2-3% 的模型,放到真实漏检率、过检率和节拍时间的约束下,表现差异远小于提示词和流程设计的影响。选定 2-3 个候选,拿自己真实业务跑 100-200 例再定,比追最新榜单靠谱得多。
第二,把成本当成第一变量。同样的需求,Flash 系和旗舰系成本差 10-60 倍,而 80% 的日常任务根本不需要旗舰。2026 年正确的架构是”场景路由”:简单任务走便宜模型,复杂任务才上旗舰,再留一个兜底链路。
第三,工业落地看三件事:延迟、确定性、隐私。视觉检测这类场景,模型只是流水线一环,真正卡脖子的是端到端延迟和输出确定性——这也是刘工坚持给多模态理解配 Gemini、给文本后端配 DeepSeek、给敏感数据配开源权重的原因。
结语
刘工判断:未来 12 个月,开源与闭源的差距会继续收窄,推理成本还会再降一个数量级,选型的胜负手会从”谁的模型最强”彻底转向”谁的场景路由最省”。2026 年没有通吃的模型,只有匹配场景、匹配预算的模型组合。这份对比会随榜单更新持续维护,收藏本站不迷路。
数据来源:LM Market Cap AI Benchmarks(2026-10-11 更新)、SWE-bench Verified / LMArena 官方榜单、TokenPAPA LLM API Benchmarks(2026-09)、iternal.ai LLM Selection Guide(2026-09,数据截至 2026-07)。本站为海外 AI 动态的中文转述与观点评论,榜单版权归原作者所有;本文为刘工基于公开数据的解读,未做任何虚构实测。
每日聚合海外 AI 一手动态与深度观点。收藏本站,不错过每一个重要信号;返回首页查看更多。
