

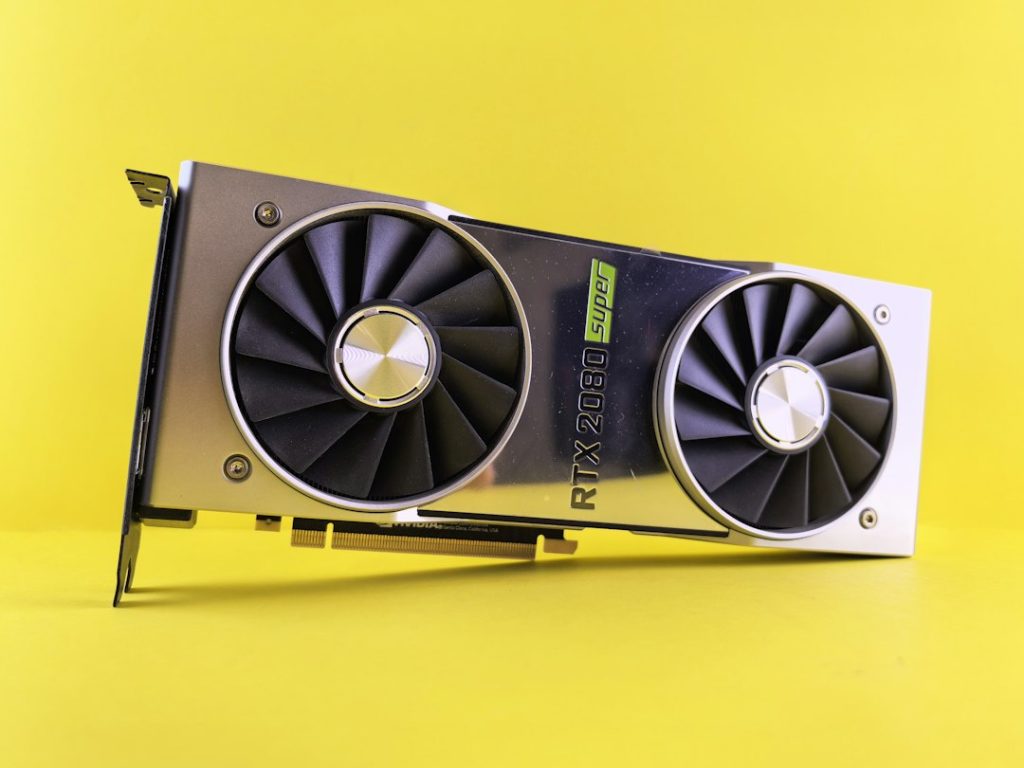
2026 年 11 月 17 日,NVIDIA 副总裁 Ian Buck 在芝加哥 SC26 特别演讲中发布 Nemotron for Science 科研智能体工具、Rubin 架构 HPC GPU 和扩展版 Vera CPU 平台,三款产品同时指向高性能计算与 AI 智能体的融合。这套工具允许研究者在自有系统上让智能体规划实验、执行代码并核验结果,把科研工作流的控制权从人工脚本交给模型。刘工判断,NVIDIA 此举重点不在卖芯片,它把智能体框架嵌进 HPC 软件栈,用软件
当地时间 2026 年 11 月 17 日上午,NVIDIA 在芝加哥麦考密克会展中心举行的 SC26(超级计算大会)上开启公司主题周,副总裁兼计算产品总经理 Ian Buck 发表特别演讲。演讲发布三项内容。第一是 Nemotron for Science,基于 Nemotron 模型系列的科研智能体工具包,具备规划实验、执行代码、核验结果三项能力,并明确在研究者自己的系统上运行,而非托管于厂商云。第二是 Rubin HPC GPU,承接 Blackwell 之后的 Rubin 架构,面向高性能计算负载,配备 HBM4 高带宽内存,与自研 CPU 通过 NVLink-C2C 互连。第三是扩展版 Vera CPU 平台,NVIDIA 自研 ARM 架构处理器,扩展后支持更大规模的节点与机架配置。Ian Buck 在演讲中将这一组合称作让科学进入智能体时代的基础设施,SC26 其余日程将围绕该路线展开。三个发布共用同一套软件栈与互连标准,构成从芯片到智能体框架的整机方案,而非单点硬件升级。
SC 系列大会长期是 HPC 硬件与网络技术的发布窗口,近三年逐渐被 AI 议题主导。NVIDIA 自 Hopper 起保持约两年一代的数据中心 GPU 节奏,Blackwell 于 2024 年量产,Rubin 按公开路线图落在 2026 年,与本届 SC26 的时间点吻合,也对应各国 HPC 中心新一轮采购周期。推动科研智能体此时落地的,有两方面因素。一是科学 AI 从判别式模型走向可执行工作流,材料、生物、气候领域的团队已不满足于模型只给出预测,而是要求自动生成并验证实验方案。二是数据主权约束趋紧,很多国家实验室与医院不允许把原始实验数据传出防火墙,云端智能体因此难以落地,本地运行成为必需。NVIDIA 同时推进自研 ARM CPU,是在 x86 主导的 HPC 存量市场中为自己争取架构话语权,延续 Grace 之后的垂直整合路径。
刘工判断:未来 12 个月内,本地可运行的科研智能体会从 GPU 附赠软件变成 HPC 采购标书里的独立评分项,NVIDIA 这次争取的是标准定义权,而不是多卖几张卡。
从技术层面看,Nemotron for Science 的关键词不是生成而是核验。规划实验、执行代码、检查结果构成一个闭环,模型必须在同一台机器上完成提出假设与证伪假设,这与云端聊天式助手有本质区别。在工业质检这类场景,刘工观察到产线最贵的环节从来不是推理速度,而是复判与追溯——一条 SMT 产线部署视觉模型后,工程师约六成工时花在确认误检与漏检的归因上。科研同理,一个能自动跑代码并回报失败原因的智能体,价值远高于一个能写出漂亮实验方案的智能体。谁能把核验环节做成标准接口,谁就握住下一轮 HPC 软件栈的入口。
在商业维度上,这是一次典型的生态加固。NVIDIA 公开路线图显示,Vera Rubin NVL144 的 FP4 推理算力约 3.6 exaflops,约为 GB300 NVL72 的 3.3 倍,而 FP64 双精度的提升幅度明显小于这个比例。这意味着 NVIDIA 正把 HPC 的卖点从传统双精度峰值转向低精度智能体吞吐,对仍以 FP64 作为采购基准的国家实验室构成范式冲击,也让只拼 FP64 的竞品难以在同一标书里对标。配套的自研 88 核 Vera CPU 进一步压缩 x86 厂商在 HPC 节点中的份额,产品形态从卖加速卡升级为卖整机架构。
对行业而言,影响会先出现在调度层。Slurm 这类作业调度器按节点和核时计费,而智能体按任务闭环计费,计费单位的改变会牵动 HPC 中心的预算模型与验收标准。刘工预测,2027 年上半年前后,主流 HPC 中心会出现第一批按智能体任务完成率结算的试点合同。风险同样清晰:本地智能体的权限边界、代码执行沙箱与结果可复现性目前都没有第三方认证,一旦智能体误判实验结论,责任归属将是采购方最现实的顾虑。
- NVIDIA 公开路线图显示,Vera Rubin NVL144 的 FP4 推理算力约 3.6 exaflops,约为 GB300 NVL72(约 1.1 exaflops)的 3.3 倍。
- 同代内存升级中,Rubin 采用 HBM4,带宽约 13 TB/s,较 GB300 所用 HBM3E 提升约 1.6 倍。
- Vera CPU 为 88 核定制 ARM 设计,较前代 72 核的 Grace 核心数增加约 22%,并通过 NVLink-C2C 与 Rubin GPU 组成超级芯片。
- 近几期 TOP500 榜单中,采用加速器的系统占比已接近四成,纯 CPU 同构系统持续减少,这是 NVIDIA 推动整机架构的存量基础。
- Nemotron for Science 明确本地部署,与云端科学智能体相比省去实验数据出境审批环节,合规周期从数月级压缩到机构内部流程。
对行业的短期影响在 3 个月内就会显现:头部 HPC 中心与超算实验室会启动小规模评估,把 Nemotron for Science 接入现有 Slurm 队列做沙箱测试;GPU 与 CPU 捆绑采购的谈判权重上升,纯加速卡订单的议价空间被压缩。中期一年看,HPC 采购标书大概率会把智能体运行环境与数据本地化能力写成独立条目,软件栈成为与峰值算力并列的评分维度。
对普通用户而言,短期 3 个月内几乎没有直接感知,变化藏在云端的科研 API 背后;一年维度的中期影响更实在——药物筛选、电池材料、催化剂设计的迭代周期若因智能体自动化而缩短,最终体现为更快的产品上市与更低的研发成本。反面同样存在:当实验方案由模型生成,公众对科研结论可复现性的信任需要新的验证机制,这部分制度建设大概率慢于硬件迭代。
值得继续思考的问题:
- 科研智能体的可核验性设计:如何把检查结果做成第三方可审计的接口,而不是模型自证。
- Vera CPU 的 88 核 ARM 路线:自研处理器如何在 x86 为主的 HPC 存量市场中切出份额。
- 本地部署智能体与数据主权:出口管制与科研数据合规如何改变科学 AI 的产品形态。
延伸阅读:2026 主流 AI 大模型对比——不追热点也能长期有用的选型指南,收藏备用。
本条动态来自 NVIDIA Blog(发布于 2026-11-17 14:00:10)。本站为海外 AI 动态的中文转述与观点评论,原文版权归原作者所有。
每日聚合海外 AI 一手动态与深度观点。收藏本站,不错过每一个重要信号;返回首页查看更多。
